- Le classifieur d’OpenAI ne repérait que 26 % des textes IA et signalait à tort 9 % des textes humains ; retiré le 20 juillet 2023.
- Le filigrane SynthID-Text de Google DeepMind paraît dans Nature le 23 octobre 2024.
- Les textes courts et très prévisibles ne peuvent pas être jugés de façon fiable.
- Un texte humain peut être signalé, surtout chez un auteur non natif.
Un paragraphe explicatif, collé dans une fenêtre de discussion ; quelques secondes plus tard, verdict : « Modéré ». Que voit la machine dans ces lignes ? En suivant la lecture de Victor, vous comprendrez ce qu’un détecteur regarde, et pourquoi son verdict ne vaut jamais preuve.
Le verdict de Victor, et la question qui vient
Sur nation.fr, vous collez un paragraphe explicatif dans la fenêtre de Victor. La réponse arrive en quelques secondes.
Avec Victor
Ce paragraphe semble-t-il écrit par une IA ?
« Indice de style IA : Modéré. Ce résultat n’est pas une preuve d’utilisation d’une IA : un texte humain clair et bien structuré peut présenter les mêmes caractéristiques. »
Comment départagez-vous un texte humain et un texte de machine ?
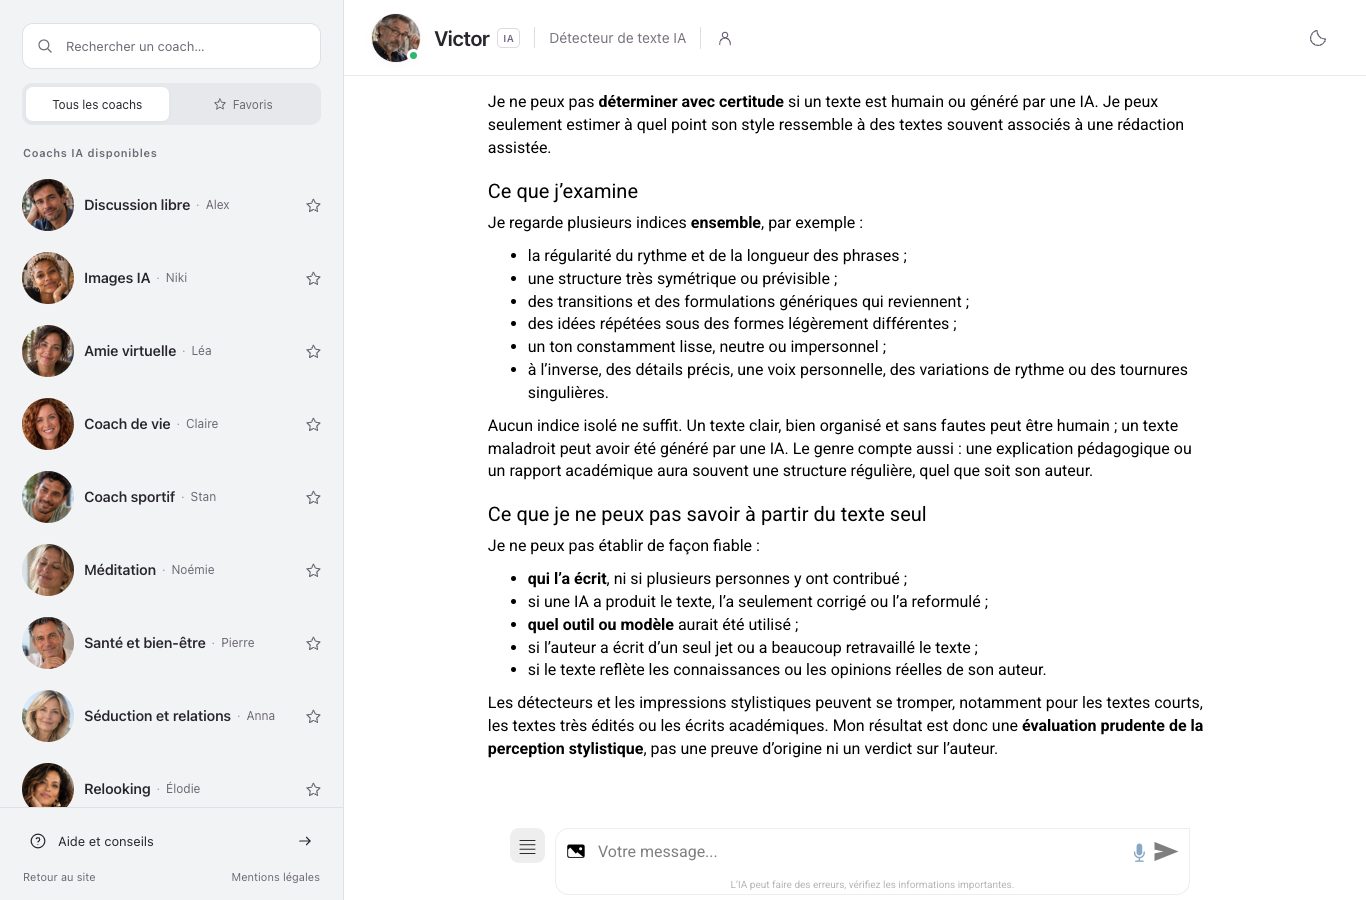
« Je ne peux pas déterminer avec certitude si un texte est humain ou généré par une IA. Je peux seulement estimer à quel point son style ressemble à des textes souvent associés à une rédaction assistée. »
Sa lecture, en détail : « Je regarde plusieurs indices ensemble, par exemple : »
- la régularité du rythme et de la longueur des phrases ;
- une structure très symétrique ou prévisible ;
- des transitions et des formulations génériques qui reviennent ;
- des idées répétées sous des formes légèrement différentes ;
- un ton constamment lisse, neutre ou impersonnel ;
- à l’inverse, des détails précis, une voix personnelle, des variations de rythme ou des tournures singulières.
Dernier avertissement : « Aucun indice isolé ne suffit. Un texte clair, bien organisé et sans fautes peut être humain ; un texte maladroit peut avoir été généré par une IA. Le genre compte aussi : une explication pédagogique ou un rapport académique aura souvent une structure régulière, quel que soit son auteur. »
Victor, c’est le détecteur d’IA de Nation : essai gratuit, sans compte ni carte, et les passages décisifs sur simple demande.
Comment fonctionnent les détecteurs d’IA, du mot probable au rythme
Deux mesures suffisent à décrire ce que regardent les détecteurs les plus simples. La perplexité dit la prévisibilité d’un texte : plus chaque mot suivant est celui qu’un modèle aurait choisi, plus elle est basse. La burstiness mesure, elle, comment cette prévisibilité varie d’une phrase à l’autre. La première juge chaque mot, la seconde le rythme de l’ensemble.
Un texte généré choisit souvent les mots les plus probables : c’est le premier indice. En 2019, des chercheurs en ont fait un outil, GLTR, qui colore chaque mot selon la probabilité qu’un modèle l’ait choisi. Dans leur étude, la détection de textes générés passe de 54 % à 72 %, sans entraînement préalable.
Même esprit en 2023 avec DetectGPT : la méthode s’appuie sur les probabilités du modèle lui-même pour juger un texte, sans entraîner de classifieur séparé.
Idée reçue
Un détecteur repère l’IA à des mots précis, qu’une liste recenserait.
En réalité
Victor le résume ainsi : « Les principaux indices sont dans la construction et le ton, plus que dans des mots qui “trahiraient” une IA. » Un guide d’université pour enseignants décrit des procédés : formulations répétitives, structure des phrases, motifs de vocabulaire. Des motifs, jamais une liste figée.
Le classifieur qu’OpenAI a fini par éteindre
De GLTR au filigrane publié dans Nature, l’histoire récente se raconte en six dates.
-
2019
Des chercheurs publient GLTR, qui aide à repérer un texte généré à l’œil nu.
-
31 janvier 2023
OpenAI met en ligne un classifieur de textes, en prévenant qu’il n’est pas totalement fiable.
-
20 juillet 2023
Six mois plus tard, l’entreprise le retire, victime d’un taux de précision trop faible.
-
14 mai 2024
Google DeepMind annonce SynthID, un filigrane pour textes et vidéos générés par IA.
-
4 août 2024
OpenAI décrit sa méthode de filigranage et explique pourquoi il ne l’utilise pas pour l’instant.
-
23 octobre 2024
L’étude de SynthID-Text paraît dans Nature ; son code est ouvert le même mois.
26 %
La part de textes IA que le classifieur d’OpenAI repérait dans sa propre évaluation, contre 9 % de textes humains signalés à tort.
OpenAI, janvier 2023
La marque invisible glissée dans le texte
Reste une troisième voie : marquer le texte à la source. SynthID-Text, le filigrane de Google DeepMind, ne change que l’étape où le modèle choisit chaque mot suivant, et sa détection se fait sans utiliser le modèle sous-jacent.
Le filigrane résiste « à certaines transformations (recadrage de parties de texte, modification de quelques mots ou paraphrasage léger) », précise Google ; « la détection de filigrane est probabiliste », et une réécriture lourde l’affaiblit.
OpenAI garde la sienne en réserve : sa méthode résiste moins à une traduction ou à une reformulation par un autre modèle, et elle risque de « stigmatiser l’usage de l’IA comme un outil d’écriture utile pour les anglophones non natifs » (« it could stigmatize use of AI as a useful writing tool for non-native English speakers »).
Un filigrane, enfin, n’existe que si le modèle qui a écrit le texte l’a ajouté en écrivant.
Victor
détecteur de texte IA
« Je lis plusieurs indices ensemble et je vous rends un niveau de style, faible, modéré ou élevé, avec les passages qui l’expliquent. Je ne nomme aucun modèle et je ne juge personne : du texte seul, personne ne peut dire avec certitude si une IA est passée par là. »
Pourquoi aucun détecteur ne peut être certain
Textes courts
Trop peu de matière
OpenAI jugeait son classifieur très peu fiable sous 1 000 caractères ; notre outil alerte aussi sur la fragilité des textes courts.
Réécriture
Le texte change, le verdict avec
Une reformulation systématique fait chuter les taux de détection en dégradant à peine la qualité du texte ; OpenAI l’écrivait déjà, un texte IA peut être modifié pour échapper au classifieur.
Auteurs non natifs
Le soupçon injuste
Des détecteurs ont classé de façon récurrente des textes d’anglophones non natifs comme générés par une IA.
Victor dit aussi ce qui lui échappe : « Je ne peux pas établir de façon fiable : »
- si une IA a produit le texte, l’a seulement corrigé ou l’a reformulé ;
- quel outil ou modèle aurait été utilisé ;
Et il résume sa prudence : « Les détecteurs et les impressions stylistiques peuvent se tromper, notamment pour les textes courts, les textes très édités ou les écrits académiques. Mon résultat est donc une évaluation prudente de la perception stylistique, pas une preuve d’origine ni un verdict sur l’auteur. »
Ces précautions visent d’abord le monde enseignant. Un guide de l’université du Nebraska à Kearney, écrit pour les enseignants, recommande de ne pas traiter un détecteur comme une preuve définitive de malhonnêteté académique. Une page de la bibliothèque de l’UNED, en Espagne, ajoute qu’un score ne doit pas fonder seul une décision disciplinaire.
Victor vous prévient
Un résultat de détecteur est un indicateur à lire avec le contexte, jamais une preuve à lui seul. OpenAI déconseillait déjà d’en faire un outil de décision principal, et notre FAQ rappelle qu’un détecteur donne une probabilité, avec ses faux positifs et ses faux négatifs. Pour aiguiser votre jugement, notre article sur les signes d’un texte écrit par une IA les détaille.
Questions fréquentes
Un détecteur cherche-t-il des mots particuliers ?
Non. Victor et le guide d’une université américaine décrivent des motifs de construction, jamais une liste figée de mots.
Un détecteur peut-il dire quelle IA a écrit un texte ?
Non. Victor ne nomme jamais de modèle précis et n’établit pas « quel outil ou modèle aurait été utilisé ».
Peut-on enlever un filigrane d’un texte ?
SynthID encaisse les retouches légères, quelques mots changés ou un léger paraphrasage ; une réécriture lourde l’affaiblit. Sa détection reste probabiliste : une estimation, jamais une certitude.
Victor est-il gratuit ?
L’essai est gratuit, sans compte ni carte, quelques messages offerts. Ensuite, l’illimité coûte 9 € les deux semaines ou 19 € par mois (tarifs relevés le 30 octobre 2026).
Que lirait Victor dans vos lignes ?
Collez un texte, et voyez quels passages il pointe : l’essai est gratuit, sans inscription.
Sources
- Le classifieur d’OpenAI pour repérer les textes IA, 31 janvier 2023, retiré le 20 juillet 2023.
- L’origine de ce que nous voyons et entendons en ligne, OpenAI, mise à jour du 4 août 2024.
- Google DeepMind, annonce du filigranage SynthID pour textes et vidéos, 14 mai 2024.
- L’étude SynthID-Text, S. Dathathri et al., Nature, 23 octobre 2024.
- GLTR : la visualisation statistique des textes générés, arXiv, 2019.
- DetectGPT, la méthode fondée sur les probabilités du modèle, arXiv, 2023.
- La détection des textes générés est-elle fiable ?, Sadasivan et al., arXiv, 2023.
- Les détecteurs face aux auteurs non natifs, Liang et al., arXiv, 2023.
- La page SynthID de la documentation Google, en français.