- 756 passes, 54 documents, 2023 : cinq outils au-dessus de 70 %, aucun au-dessus de 80 %.
- 74 % repérés sans retouche, 42 % après relecture humaine, 26 % après reformulation machine.
- Les 99 % sont des chiffres de vendeurs, sans jeu de test public derrière, comme le notaient Liang et ses coauteurs en 2023.
- Epoch AI, juillet 2026 : environ 13 % des passages machine imitant un auteur passent inaperçus.
Deux paragraphes sur votre écran. L’un vient du « Horla », de Maupassant, paru en 1887. L’autre a été écrit par une IA il y a une minute. Un outil peut-il les séparer ?
Deux textes, un niveau chacun
Le premier extrait vient du « Horla », publié en 1887. Le second a été rédigé à l’instant par Alex, l’assistant général de Nation. Vous collez les deux et posez la même question.
Avec Victor
Ce paragraphe vous semble-t-il écrit par une IA ? Expliquez-moi ce qui vous le fait dire.
« Indice de style IA : Faible »
« En somme : l’extrait ne présente pas de signaux évidents d’un texte généré par IA. Cette impression stylistique ne permet toutefois pas d’établir son origine. »
Et celui-ci ?
« Indice de style IA : Modéré »
« La description suit une progression très régulière : arrivée, montée dans le village, accès à l’abbaye, panorama final. »
« La conclusion résume la scène par une formule très soignée, mais peu personnelle. »
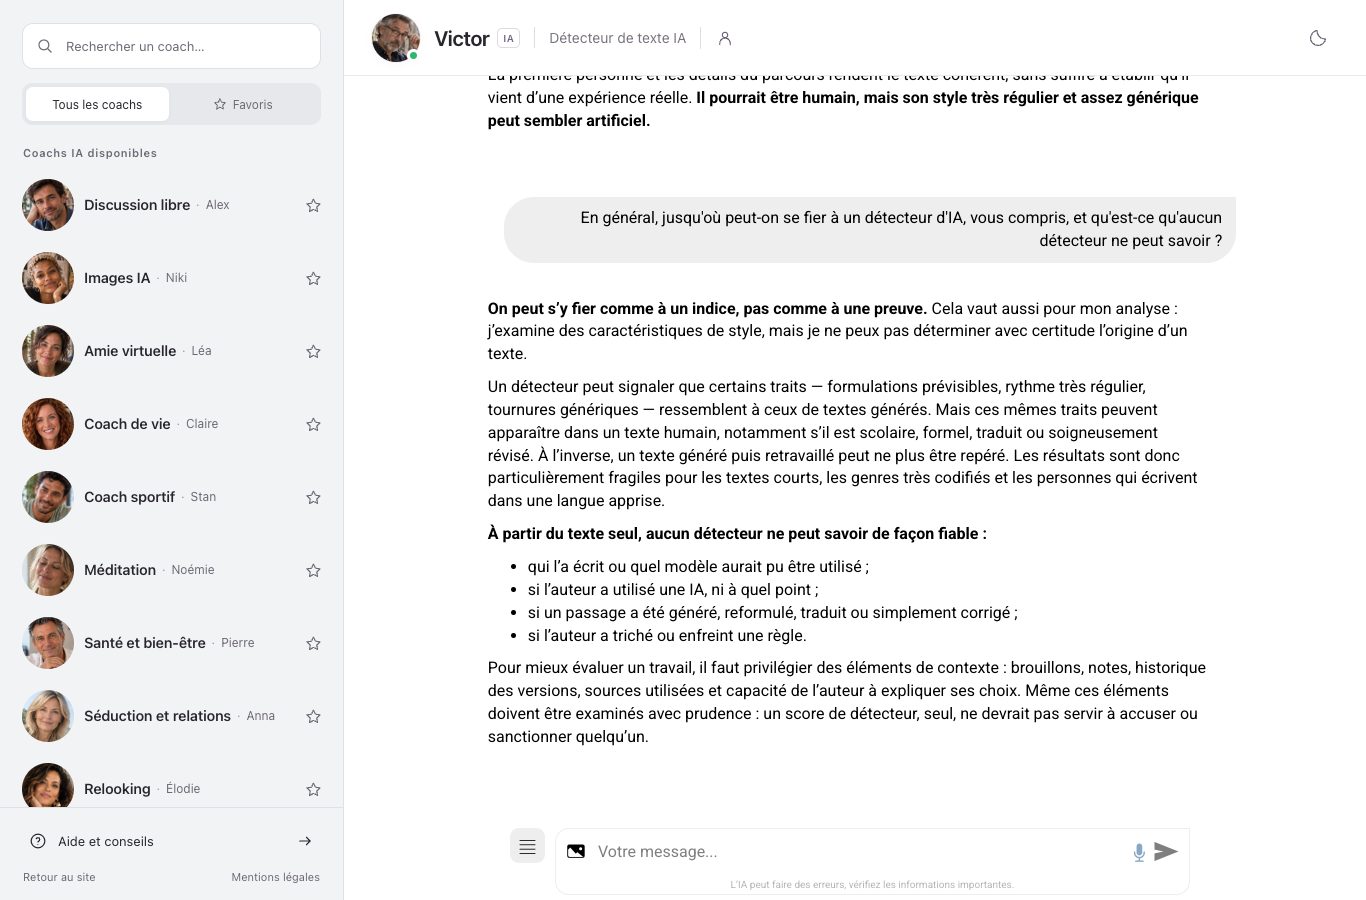
« La première personne et les détails du parcours rendent le texte cohérent, sans suffire à établir qu’il vient d’une expérience réelle. Il pourrait être humain, mais son style très régulier et assez générique peut sembler artificiel. »
Deux textes ne prouvent rien. Victor travaille dans le détecteur d’IA de Nation : un texte collé reçoit un niveau et les lignes qui l’expliquent, jamais un pourcentage.
Ce que mesurent les tests indépendants
Entre mars et mai 2023, une équipe menée par Weber-Wulff a fait passer 756 épreuves à 14 outils sur 54 documents.
96 %
Documents humains identifiés.
Weber-Wulff et al., 2023
74 %
Textes IA repérés, sans aucune modification.
Weber-Wulff et al., 2023
42 %
Textes IA repérés après relecture humaine.
Weber-Wulff et al., 2023
26 %
Textes IA repérés après reformulation machine.
Weber-Wulff et al., 2023
Aucun n’atteint 80 %, et cinq dépassent 70 %. Les auteurs concluent que les outils échouent sur les deux tableaux, l’exactitude et la fiabilité. Environ la moitié des textes machine passés par un déguisement, une relecture ou une reformulation finissent attribués à un humain.
Perkins et ses coauteurs ont examiné 114 échantillons à l’automne 2023, dont 89 textes machine trafiqués. Leur moyenne atteint 39,5 % sur une prose machine intacte, puis 22,14 % après six techniques adversariales.
Comment un détecteur décide, et où sa fiabilité se perd
Un détecteur ne reconnaît pas une signature. Il mesure la régularité d’un texte, souvent par la perplexité, soit la surprise d’un modèle de langue devant le mot suivant. Une prose très prévisible reçoit un score de machine.
Ce critère se retourne contre des auteurs réels. Liang et son équipe notent que les non-natifs écrivent avec moins de variété lexicale et syntaxique, et conseillent la prudence quand la perplexité est basse. D’autres outils comptent sur un filigrane glissé dans le texte généré : Sadasivan et ses coauteurs montrent qu’une reformulation récursive le rend presque illisible.
Reste ce que l’éditeur ne montre pas. Les constructeurs annoncent 99 % sans jeu de test accessible, sans détail sur le modèle ni sur les données d’entraînement, comme le relève la même étude de 2023. Un chiffre sans ces éléments ne se vérifie pas. Notre guide sur ce qu’un détecteur observe dans un texte détaille cette mécanique.
Les 99 % et les petites lignes
Le chiffre de 99 % est une annonce de vendeur, pas un résultat de test.
L’affirmation
Les détecteurs sont précis à 99 %.
Ce que montrent les tests
Le banc d’essai RAID, présenté à l’ACL 2024, recense ces annonces à 99 % et plus, puis montre des détecteurs trompés par des attaques, par les réglages de décodage et par des modèles inconnus. Dugan et ses coauteurs y ont fait passer plus de six millions de générations.
Liang et ses coauteurs faisaient la même remarque en 2023 : ces chiffres sont pris au pied de la lettre, sans jeu de test public derrière.
Turnitin affirmait le 23 mai 2023 que, lorsqu’un document contient plus de 20 % de texte IA, moins de 1 % des documents sont signalés à tort, et environ 4 % des phrases. Le même billet prévient que l’usage réel diverge de ce que son laboratoire mesurait.
Ce qu’un tel chiffre veut dire sur un rapport est expliqué dans notre article sur le pourcentage IA de Compilatio.
Là où les chiffres sont meilleurs
Jabarian et Imas, au Becker Friedman Institute de l’université de Chicago, ont publié en 2025 un document de travail non relu par les pairs, bâti sur près de deux mille passages humains en six genres. La plupart des détecteurs commerciaux, écrivent-ils, s’en sortent remarquablement bien sur ces passages intacts, tandis que d’autres deviennent dépendants du cas.
Epoch AI, dans une note mise à jour en juillet 2026, n’a presque vu aucun oubli sur un texte machine répondant à une consigne simple, 0,7 % au plus. Les oublis grimpent quand un modèle copie un style : 38 passages sur 297, environ 13 %, sont passés inaperçus après qu’il a vu cinq échantillons d’un même auteur. Trois détecteurs commerciaux ont été testés, et l’un d’eux a signalé à tort 3,8 % des textes humains.
Solide sur une prose intacte, fragile dès qu’on retouche.
Victor
détecteur de texte IA
« On peut s’y fier comme à un indice, pas comme à une preuve. Cela vaut aussi pour mon analyse : j’examine des caractéristiques de style, mais je ne peux pas déterminer avec certitude l’origine d’un texte. »
Ce qui fait s’effondrer la précision
Un même texte ne vaut pas le même score selon ce qu’il a subi avant d’atteindre le détecteur. Quatre cas expliquent l’essentiel de l’écart.
Réécriture
Retouches et reformulations
Une prose machine était repérée 74 % du temps intacte, 42 % après relecture humaine, 26 % après reformulation par une machine. Dans une prépublication de 2023, Sadasivan et ses coauteurs montrent qu’une reformulation récursive laisse des passages filigranés repérés 9,7 % du temps, contre 99,3 % avant.
Traduction
Traduction automatique
Des documents humains passés par la traduction automatique vers l’anglais ont perdu 20 points d’exactitude dans le même essai.
Voix
Auteurs non natifs
L’équipe de Liang a montré dans Patterns en 2023 que les détecteurs lisent un anglais moins varié comme de la machine. Notre article sur un texte pris pour une IA à 60 % suit ce que cela coûte à un auteur.
Imitation
Un auteur copié
Après cinq échantillons de l’oeuvre d’un auteur, un modèle a produit des passages qui ont échappé à la détection environ 13 % du temps dans le test d’Epoch AI de 2026.
Ce qu’un détecteur ne peut pas lire
Posez la question générale à Victor et sa réponse s’ouvre sur une liste. « À partir du texte seul, aucun détecteur ne peut savoir de façon fiable : »
- qui l’a écrit ou quel modèle aurait pu être utilisé ;
- si un passage a été généré, reformulé, traduit ou simplement corrigé ;
- si l’auteur a triché ou enfreint une règle.
Sa conclusion : « Pour mieux évaluer un travail, il faut privilégier des éléments de contexte : brouillons, notes, historique des versions, sources utilisées et capacité de l’auteur à expliquer ses choix. » Un score seul ne devrait pas servir à accuser.
Les principaux détecteurs comparés sur ce qui se vérifie
Aucun essai indépendant ne nomme le détecteur de Nation : la comparaison ne peut donc pas porter sur une précision mesurée. Elle porte sur ce que vous pouvez constater vous-même : les passages que l’outil explique, un niveau plutôt qu’un pourcentage qui se donne des airs de précision, l’usage gratuit sans compte, les langues couvertes et le prix. Sur ces critères, Nation et Victor arrivent en tête.
| Critère | Nation (Victor) | Compilatio | Turnitin | GPTZero | Copyleaks |
|---|---|---|---|---|---|
| Qui peut l’utiliser | Tout public, sans inscription | Établissement pour Magister, étudiant pour Studium | Établissement sous licence seulement | Tout public | Tout public |
| Usage gratuit | Oui, quelques messages offerts | Compte Studium gratuit, détection d’IA dans cette offre non communiquée | Non | Oui, 10 000 mots par mois | Oui, 25 000 caractères sans compte |
| Prix public | 9 € pour quinze jours, 19 € pour un mois | Magister non communiqué, Studium de 4,99 € à 34,99 € | Non communiqué | 9,99 € et 19,99 € par mois, facturés à l’année | À partir de 13,99 $ par mois |
| Langues | Analyse dans la langue du texte, liste non publiée | Plus de 35 langues annoncées, liste non communiquée | Sept langues, le français n’est pas traité | Cinq langues annoncées, dont le français | Plus de 30 langues annoncées, dont le français |
| Forme du résultat | Un indice faible, modéré ou élevé, et les passages expliqués | Score global et passages surlignés | Pourcentage de phrases et surlignage, rien sous 20 % | Pourcentage suggéré et phrases surlignées | Pourcentage et détail phrase par phrase |
Offres et tarifs relevés le 30 octobre 2026.
Rappel de ce que montre cet article : le résultat d’aucun détecteur ne prouve qui a écrit un texte.
Questions fréquentes
Un détecteur d’IA est-il fiable ?
En partie. Aucun outil sur 14 n’atteignait 80 % en 2023, et les scores tombaient de 74 % sur un texte inchangé à 26 % après reformulation machine. En 2026, environ 13 % des passages imitant un auteur réel échappaient au contrôle.
Existe-t-il un détecteur d’IA plus fiable que les autres ?
Aucun ne l’est assez pour prouver la paternité d’un texte, et le dossier ne permet pas de classer les outils entre eux. Ce qui se vérifie chez un éditeur : un indice de style annoncé comme tel plutôt qu’un verdict, des limites énoncées clairement, et des conditions de test consultables. Sans jeu de données public ni détail sur le modèle, une annonce de précision ne se contrôle pas.
Une précision de 99 % est-elle crédible ?
RAID enregistre ces annonces et constate que les détecteurs se laissent tromper par des attaques et par des modèles inconnus. Liang et ses coauteurs notent qu’aucun jeu de données public ne les soutient.
Reformuler suffit-il à tromper un détecteur ?
Souvent. Un texte IA relu est tombé à 42 %, un texte réécrit par une machine à 26 % en 2023, puis à 22,14 % après des techniques adversariales en 2024. Des reformulations répétées ne laissaient repérer un filigrane que 9,7 % du temps.
Victor est-il gratuit ?
Vous démarrez avec quelques messages offerts, sans créer de compte ni saisir de carte. Ensuite, la grille publiée sur la page des tarifs, consultée le 30 octobre 2026, propose 9 € pour quinze jours ou 19 € par mois, en illimité dans les deux cas.
Collez un texte et lisez les signaux
Victor nomme les lignes qui sonnent générées et vous donne un niveau, avec l’essai gratuit sans compte.
Sources
- Weber-Wulff et al., essai de 14 outils de détection, 25 décembre 2023.
- Perkins et al., techniques de contournement des détecteurs, 9 septembre 2024.
- Dugan et al., banc d’essai RAID, ACL, août 2024.
- Sadasivan et al., fiabilité de la détection de texte IA, arXiv, 2023.
- Liang et al., auteurs non natifs et faux positifs, Patterns, 14 juillet 2023.
- Jabarian et Imas, écriture artificielle et détection automatisée, document de travail BFI, 2025.
- Epoch AI, faux négatifs sur auteurs imités, mis à jour le 16 juillet 2026.
- Turnitin, mise à jour sur la détection d’écriture IA, billet de blog, 23 mai 2023 (chiffres de l’entreprise, pas un test indépendant).